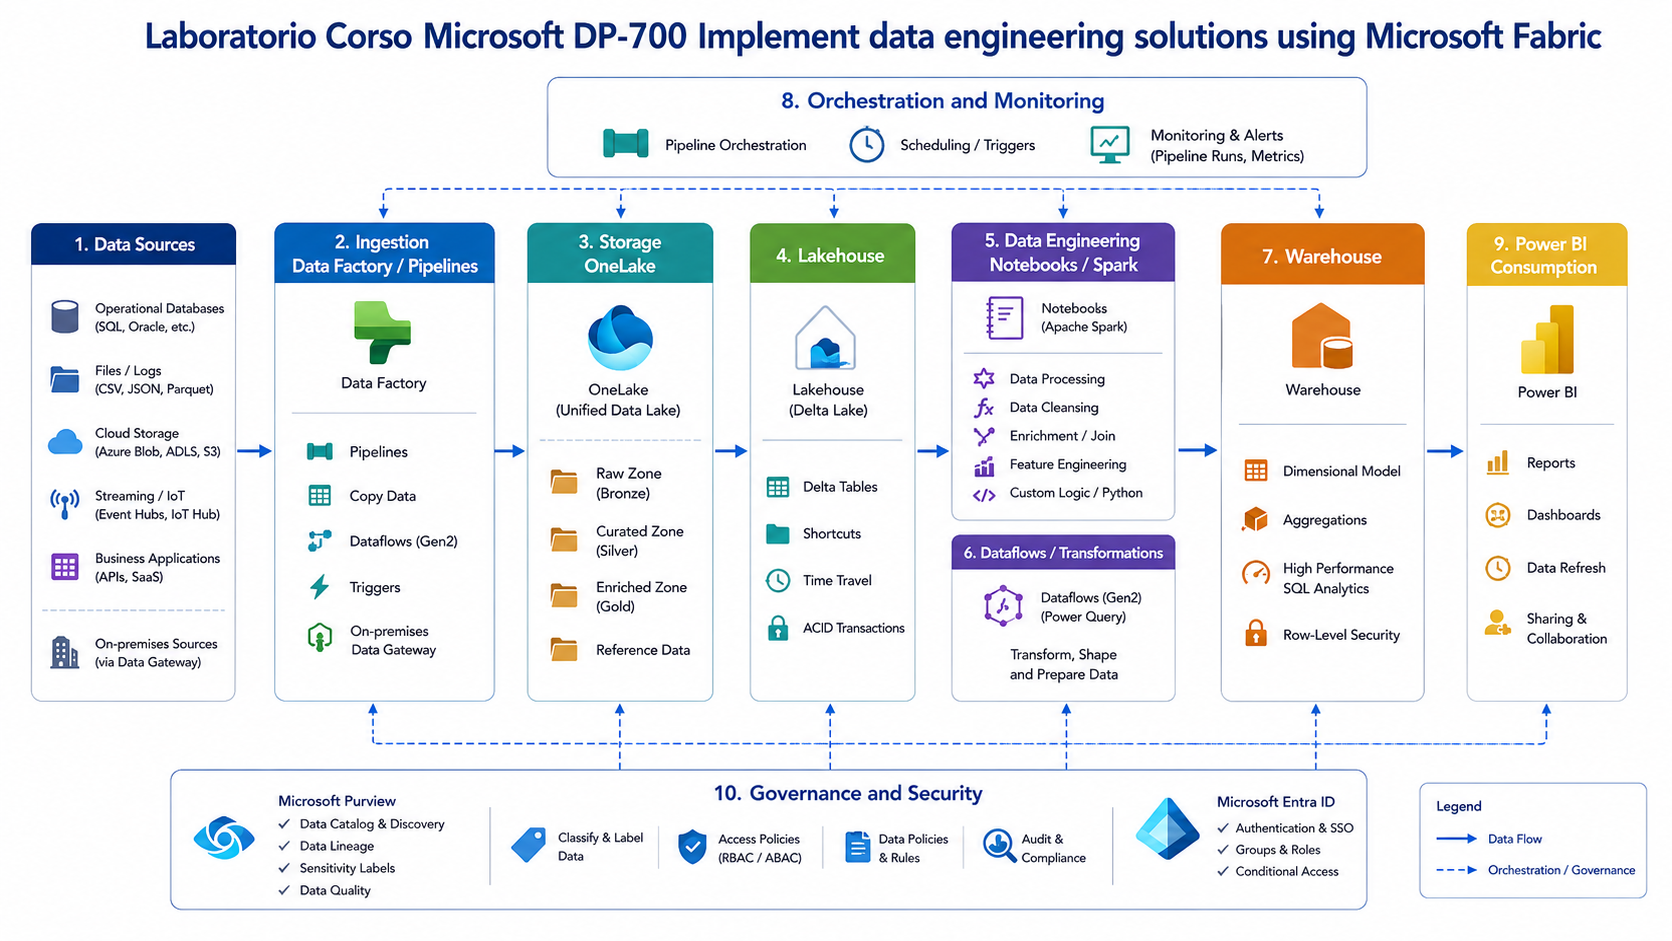
Una pipeline dati non è soltanto un caricamento riuscito: deve essere ripetibile, monitorabile, recuperabile e capace di gestire dati inaspettati. DP-700 collega le scelte architetturali di Microsoft Fabric a processi di ingestione, trasformazione e orchestrazione che devono continuare a funzionare anche quando le sorgenti cambiano.
In breve: destinatari, livello e obiettivo
- Corso di riferimento: Microsoft DP-700 – Fabric Data Engineer.
- A chi serve: Per data engineer, tecnici dati e cloud specialist con esperienza su SQL, trasformazioni e concetti di warehouse e lakehouse. Sono utili nozioni di Python e orchestrazione.
- Programma: competenze, scenari e argomenti pubblicati del corso, senza presupporre esame o voucher compresi.
- Calendario e modalità: la fonte aggiornata è la scheda completa del corso Microsoft DP-700 – Fabric Data Engineer; una data proposta non equivale a una partenza confermata.
Perché queste competenze sono importanti nel lavoro
Una piattaforma riceve ogni notte file da più sedi. Se cambia lo schema o il job viene interrotto, non deve aggiornare report con dati incompleti. Servono controlli di qualità, dipendenze esplicite, gestione dei retry e possibilità di ricostruire l'elaborazione da un punto noto.
Le competenze chiave da padroneggiare
- Architettura OneLake, lakehouse, warehouse e workspace.
- Ingestione dei dati batch e incrementale.
- Pipeline, Dataflow Gen2 e trasformazione con strumenti Fabric.
- Organizzazione e ottimizzazione degli asset dati.
- Orchestrazione, scheduling e osservabilità dei flussi.
- Sicurezza, controllo accessi, versionamento e deployment.
Programma tecnico: gli argomenti spiegati per area
Le aree seguenti derivano dal programma corrente pubblicato per il corso: aiutano a leggere le competenze nel loro contesto, prima di scegliere una specifica edizione.
Configurare workspace e workload Microsoft Fabric
- Workspace setting per Spark e OneLake
- Domain e organizzazione degli asset
- Configurazione dei workload e delle risorse di data engineering
Gestire lifecycle e deployment
- Version control e Git integration
- Database project e gestione delle modifiche
- Deployment pipeline e promozione tra ambienti
Proteggere e governare la soluzione
- Workspace e item permission
- Row, column, object e file-level access
- Dynamic data masking, sensitivity e governance
Progettare lakehouse e architetture dati
- OneLake, lakehouse e Delta table
- Medallion architecture e organizzazione dei layer
- Shortcut, schema e pattern di caricamento
Ingerire dati batch
- Data pipeline e Copy activity
- Dataflow Gen2
- Caricamento incrementale e gestione delle dipendenze
Ingerire dati streaming e real-time
- Eventstream ed Eventhouse
- Sorgenti streaming e routing degli eventi
- KQL e trasformazioni per dati in tempo reale
Trasformare dati con Spark e notebook
- PySpark e DataFrame
- Notebook e job riutilizzabili
- Ottimizzazione delle trasformazioni e scrittura Delta
Trasformare dati con SQL e KQL
- T-SQL per warehouse e lakehouse
- KQL per analisi e trasformazione real-time
- Scelta del motore in base al workload
Orchestrare processi data engineering
- Pipeline, notebook e Dataflow coordinati
- Parametri, trigger e dipendenze
- Gestione degli errori e riavvio dei processi
Monitorare e ottimizzare la soluzione
- Monitoring hub e run history
- Performance di Spark, SQL e pipeline
- Troubleshooting, capacity e ottimizzazione dei costi
Uno scenario applicativo, dal problema alla verifica
Una piattaforma deve ricevere dati giornalieri da sistemi diversi: errori di schema e duplicazioni non devono compromettere i report. Servono pipeline monitorate e recuperabili.
Un esercizio non è completo quando la modifica viene semplicemente applicata. È necessario definire il risultato atteso, misurare lo stato iniziale, verificare ciò che cambia e conservare le evidenze utili per spiegare l'esito o ripristinare la situazione precedente.
Laboratori e attività pratiche previste dal programma
- Costruire una pipeline Fabric che ingerisce dati batch verso OneLake o lakehouse con gestione delle dipendenze.
- Trasformare dati con Spark, SQL o KQL e produrre tabelle curate secondo un pattern medallion.
- Orchestrare, proteggere e monitorare il workflow analizzando run history, errori e utilizzo della capacity.
Le attività provengono dal programma pubblicato. Ambienti, durata delle esercitazioni, materiali e accessi sono regolati dalla specifica edizione: non devono essere dedotti dalla sola descrizione della guida.
Errori frequenti e scelte da evitare
- Rilanciare pipeline non idempotenti causando duplicazioni di dati.
- Non distinguere dati raw, curated e serving.
- Tralasciare accessi e permessi quando si usano shortcut fra workspace.
- Monitorare soltanto il successo tecnico del job, non la qualità dell'output.
- Pubblicare notebook e pipeline senza versionamento e promozione controllata.
Verifica i prerequisiti prima dell'iscrizione
- Saper interrogare dati con SQL o strumenti equivalenti.
- Capire join, trasformazioni e struttura dei dataset.
- Conoscere almeno le basi di cloud data platform.
- Avere familiarità con monitoraggio e gestione di pipeline.
Se il corso interessa un team aziendale
Per un team dati conta creare runbook e ownership chiari delle pipeline: gli strumenti devono aiutare a diagnosticare le anomalie, ricalcolare i dati e comunicare lo stato agli analisti.
Edizioni, modalità di frequenza e certificazione
Consulta la scheda completa del corso Microsoft DP-700 – Fabric Data Engineer per formule, durata, prezzi, iscrizione e calendario aggiornato. Le edizioni possono essere pianificate, proposte o attivabili su richiesta, con stati distinti.
Verifica contenuti aggiornati, esami e requisiti nella documentazione ufficiale del vendor. La frequenza del corso non conferisce automaticamente un titolo e non implica voucher incluso.
Domande frequenti
Domande frequenti
DP-700 è uguale a DP-600?
No, DP-700 è focalizzato sui flussi e sull'ingegneria dei dati; DP-600 sull'analisi e sui modelli semantici.
Serve conoscere SQL?
È fortemente consigliato.
Si studiano pipeline?
Sì, l'orchestrazione e l'elaborazione sono argomenti centrali.
Il corso include obbligatoriamente l'esame?
No, condizioni e voucher dipendono dalla specifica edizione.
Che cosa rende un caricamento idempotente?
Ripetere l'operazione produce lo stesso risultato previsto, evitando duplicazioni o stati incoerenti.
Perché separare raw e curated?
Per preservare il dato di origine e applicare controlli di qualità e trasformazioni verificabili.
<small>Approfondimento editoriale Vega Training basato sul programma del corso e sulle fonti indicate. Gli argomenti e gli esami possono variare nel tempo.</small>