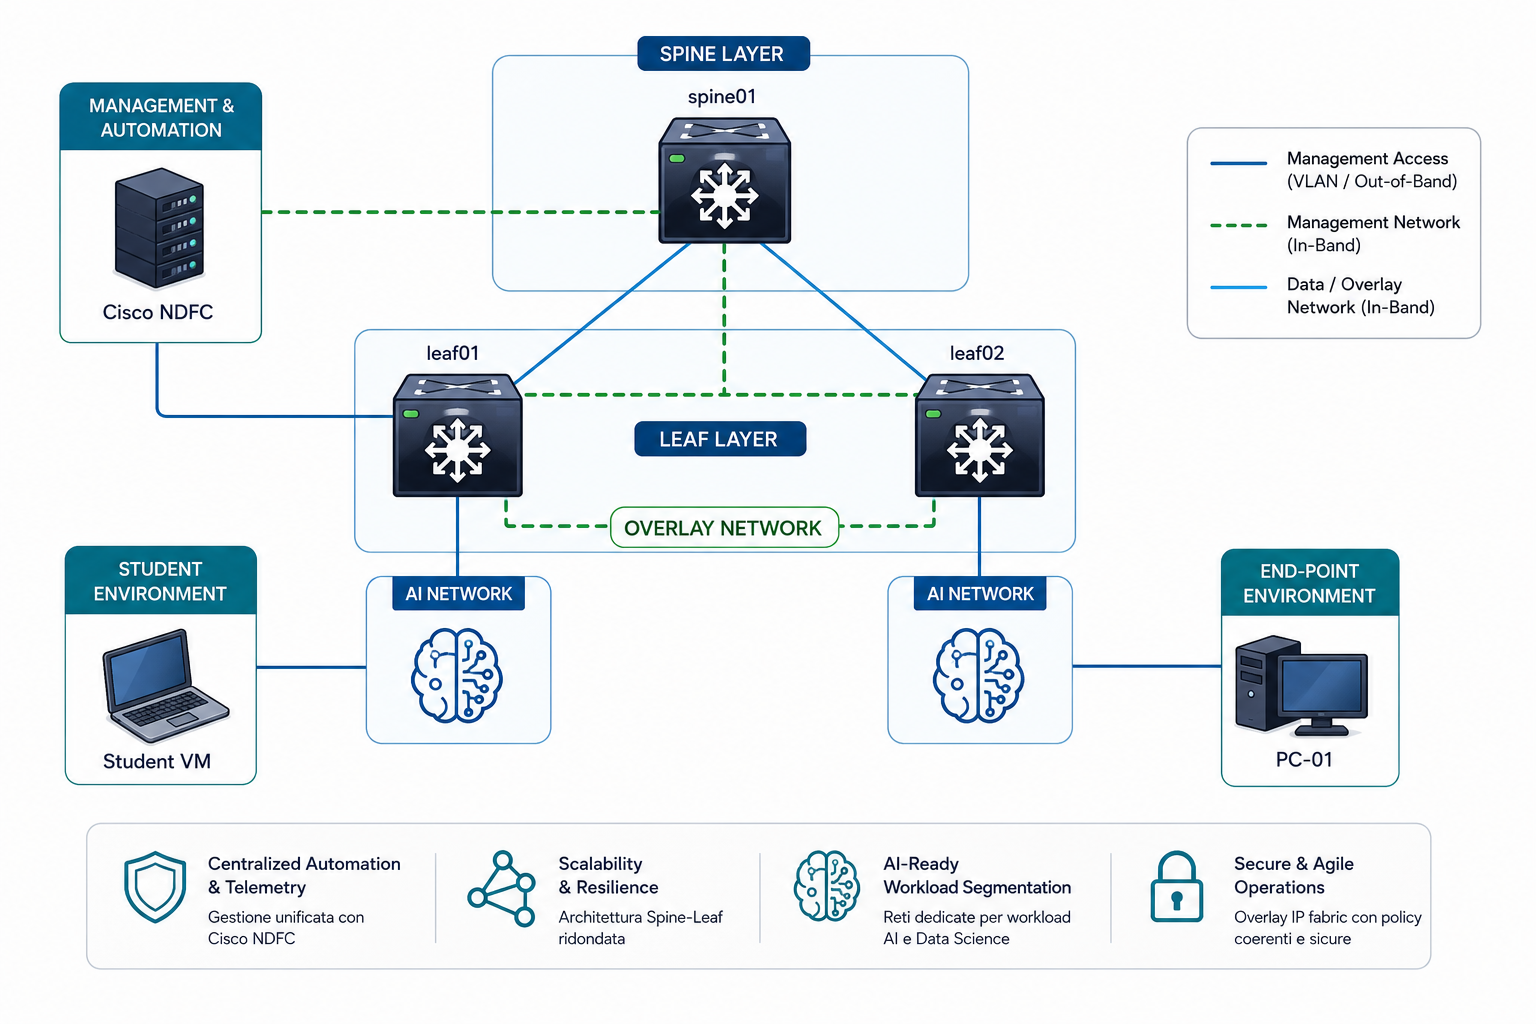
Le reti che supportano workload AI devono gestire comunicazioni intense fra acceleratori, latenze prevedibili e un equilibrio delicato fra throughput e congestione. Una GPU potente non compensa un fabric progettato male. DCAI collega requisiti del carico, trasporto Ethernet, controllo della congestione e osservabilità di cluster distribuiti.
In breve: destinatari, livello e obiettivo
- Corso di riferimento: Cisco DCAI – Data Center AI Infrastructure.
- A chi serve: Per data center engineer, network architect e professionisti infrastrutturali che lavorano con reti AI e cluster ad alte prestazioni. Sono richieste basi solide di networking e architetture data center.
- Programma: competenze, scenari e argomenti pubblicati del corso, senza presupporre esame o voucher compresi.
- Calendario e modalità: la fonte aggiornata è la scheda completa del corso Cisco DCAI – Data Center AI Infrastructure; una data proposta non equivale a una partenza confermata.
Perché queste competenze sono importanti nel lavoro
Durante un job distribuito, il throughput fra nodi è instabile e i tempi di completamento aumentano. Occorre misurare i flussi east-west, distinguere limiti compute e storage, verificare congestion management e valutare l'effetto di PFC o ECN. Intervenire alla cieca può migliorare un flusso e peggiorarne un altro.
Le competenze chiave da padroneggiare
- Architettura AI infrastructure e requisiti dei workload distribuiti.
- Ethernet per AI, RDMA e RoCE: comportamento del trasporto.
- Congestion management, PFC ed ECN, prevenzione del packet loss.
- Piattaforme Cisco Nexus, fabric e networking data center.
- Gestione con strumenti di automazione e controller Cisco.
- Integrazione con compute, storage, monitoring e troubleshooting.
Programma tecnico: gli argomenti spiegati per area
Le aree seguenti derivano dal programma corrente pubblicato per il corso: aiutano a leggere le competenze nel loro contesto, prima di scegliere una specifica edizione.
Fondamenti AI, Generative AI e modelli
- Artificial Intelligence, Machine Learning e Deep Learning
- Training, inference e ciclo di vita dei modelli
- Generative AI, foundation model e Large Language Model
- Modelli pre-trained, fine-tuning e ottimizzazione
- Retrieval-Augmented Generation e grounding dei contenuti
- Use case AI per Data Center e network operations
- Accuracy, bias, hallucination e limiti operativi
Architettura, governance e workload placement
- Componenti essenziali di un’infrastruttura AI moderna
- Requisiti di training, inference e distributed processing
- Workload placement tra compute, rete e storage
- Interoperabilità tra componenti e piattaforme
- Scalabilità, resilienza, latenza e throughput
- AI policies e governance enterprise
- Compliance, sicurezza e gestione del rischio
AI transport e fabric Ethernet ad alte prestazioni
- Pattern di traffico east-west dei workload AI/ML
- Tecnologie ottiche e copper per alta capacità
- Connectivity model per cluster distribuiti
- Layer 2 e Layer 3 negli ambienti AI
- Application-level protocol e comportamento dei flussi
- High-throughput converged Ethernet fabric
- Remote Direct Memory Access e RDMA over Converged Ethernet
Data preparation, compute, acceleratori e storage
- Data preparation e qualità del dato
- Data pipeline e movimento dei dataset
- Performance dei workload AI/ML e identificazione dei colli di bottiglia
- GPU, acceleratori e AI-enabling hardware
- Compute resource per training e inference
- Cisco UCS e integrazione delle risorse compute
- Virtual resource, isolamento e allocazione
Cisco Nexus, NDFC e visibilità della fabric AI
- Cisco Nexus per fabric AI ad alte prestazioni
- Nexus Dashboard Fabric Controller e fabric provisioning
- Template e policy per workload AI/ML
- Cisco Nexus Dashboard e health visibility
- Nexus Dashboard Insights per flow analytics
- Congestion visibility e analisi ECN PFC
- Telemetry streaming e metriche operative
Deploy di cluster AI e soluzioni RAG
- Pianificazione e preparazione di un cluster AI
- Configurazione di network, compute e storage
- Validazione della connettività e della readiness
- Ambiente Python e Jupyter per attività tecniche
- Distribuzione di modelli GPT open source
- Costruzione di una pipeline Retrieval-Augmented Generation
- Integrazione di dati infrastrutturali nel retrieval
Operations, monitoring e lifecycle management
- Day-2 operations per infrastrutture AI-enabled
- Lifecycle management di rete, compute e storage
- Monitoring dei workload e dei flussi AI/ML
- Log correlation e analisi degli eventi
- Timing protocol e coerenza temporale dei dati
- Splunk per telemetria e investigazione operativa
- Capacity planning e trend delle performance
Troubleshooting integrato dell’infrastruttura AI
- Metodo strutturato e raccolta della baseline
- Troubleshooting di latenza, packet loss e congestion
- Diagnosi di RDMA, RoCE, ECN e PFC
- Problemi di compute, acceleratori e resource exhaustion
- Problemi di storage e data access performance
- Analisi di workload placement e interoperability
- Correlazione tra telemetria, log e sintomi applicativi
Uno scenario applicativo, dal problema alla verifica
Un cluster presenta prestazioni intermittenti durante la comunicazione fra nodi GPU. Il troubleshooting deve distinguere congestione, trasporto, configurazione fabric e limiti delle risorse.
Un esercizio non è completo quando la modifica viene semplicemente applicata. È necessario definire il risultato atteso, misurare lo stato iniziale, verificare ciò che cambia e conservare le evidenze utili per spiegare l'esito o ripristinare la situazione precedente.
Laboratori e attività pratiche previste dal programma
- AI workload: Modelli, Jupyter, dataset, cluster, Generative AI e Retrieval-Augmented Generation.
- Fabric: RDMA, RoCE, ECN, PFC, lossless Ethernet, NDFC e congestion visibility.
- Infrastructure: Compute, acceleratori, virtualizzazione e storage per training e inference.
- Operations: Nexus Dashboard, telemetria, Splunk, log correlation e troubleshooting end-to-end.
Le attività provengono dal programma pubblicato. Ambienti, durata delle esercitazioni, materiali e accessi sono regolati dalla specifica edizione: non devono essere dedotti dalla sola descrizione della guida.
Errori frequenti e scelte da evitare
- Valutare le prestazioni AI guardando soltanto alle GPU.
- Abilitare meccanismi lossless senza comprenderne impatti e condizioni.
- Trascurare l'osservabilità dei buffer e della congestione.
- Confrontare architetture senza caratterizzare training e inference.
- Ignorare vincoli di potenza, raffreddamento e resilienza dell'infrastruttura.
Verifica i prerequisiti prima dell'iscrizione
- Avere solide basi switching e routing data center.
- Comprendere il ruolo di compute e storage distribuito.
- Conoscere concetti di latenza, bandwidth e pacchetti persi.
- Essere pronti a lavorare con strumenti di osservabilità.
Se il corso interessa un team aziendale
Nei progetti AI il network engineer deve dialogare con chi gestisce cluster e modelli. Questa guida aiuta a costruire una matrice comune di requisiti, prestazioni attese e verifiche prima di scalare l'ambiente.
Edizioni, modalità di frequenza e certificazione
Consulta la scheda completa del corso Cisco DCAI – Data Center AI Infrastructure per formule, durata, prezzi, iscrizione e calendario aggiornato. Le edizioni possono essere pianificate, proposte o attivabili su richiesta, con stati distinti.
Verifica contenuti aggiornati, esami e requisiti nella documentazione ufficiale del vendor. La frequenza del corso non conferisce automaticamente un titolo e non implica voucher incluso.
Domande frequenti
Domande frequenti
È un corso di sviluppo modelli AI?
No. Il focus è l'infrastruttura di rete e data center che esegue i workload.
Che cos'è RoCE?
È un meccanismo per utilizzare RDMA su Ethernet, con requisiti specifici di rete.
Sono necessarie basi data center?
Sì, networking avanzato e architetture fabric sono consigliati.
L'esame è obbligatoriamente incluso?
No, il percorso d'esame rimane separato dalla formazione.
Perché il traffico east-west è così importante?
Nei workload distribuiti molta comunicazione avviene fra nodi del cluster, non soltanto verso Internet.
RoCE coincide con una rete Ethernet ordinaria?
Usa Ethernet per trasporto RDMA, ma richiede attenzione specifica a congestione, perdita e configurazione del fabric.
<small>Approfondimento editoriale Vega Training basato sul programma del corso e sulle fonti indicate. Gli argomenti e gli esami possono variare nel tempo.</small>