VEGA TRAININGFormazione IT ufficiale e certificataChiama · 800 177 596
Corsi Microsoft/Data / AI / Analytics / Database/DP-750 · Implement data engineering solutions using Azure Databricks
Formazione Microsoft ufficialeLive con docenteLaboratorio praticoData / AI / Analytics / Database

Corso Microsoft DP-750: Implement data engineering solutions using Azure Databricks

DP-750 · Intermediate · Data Engineer

Corso Microsoft per progettare e implementare soluzioni di data engineering end-to-end con Azure Databricks e Unity Catalog: configurazione dell'ambiente, governance, ingestione, trasformazione, qualità dei dati, pipeline, workload, deployment e monitoraggio.

Formula intensiva4 giorni
LiveDocente e classe in tempo reale
EsameDP-750
Hands-onAttività laboratoriali lungo il percorso

Microsoft indica conoscenze fondamentali di data analytics, cloud storage e organizzazione dei dati, dimestichezza con SQL e Python, familiarità con notebook, Azure Databricks e Unity Catalog, nozioni di sicurezza Azure e Microsoft Entra ID e fondamenti di Git.

CorsoDP-750 · Implement data engineering solutions using Azure Databricks
Chiama
Microsoft Training Services Partner

Con Vega Training segui formazione Microsoft live con docente nell’ecosistema Microsoft Training Services Partner, con contenuti ufficiali e confronto in tempo reale.

Scopri la formazione ufficiale Microsoft
Esame e certificazione di riferimento: DP-750

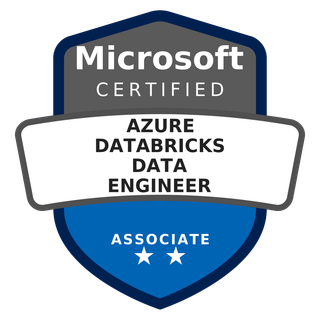
Microsoft Certified: Azure Databricks Data Engineer Associate e l’esame DP-750 sono il riferimento Microsoft collegato ai temi del corso: un punto chiaro per orientare il tuo percorso di crescita e certificazione.

Scopri il riferimento Microsoft
Corso attivabile su richiesta

Concordiamo insieme la prossima data

Il corso può essere attivato per privati, professionisti, aziende ed enti, senza attendere la pubblicazione di una data a calendario.

Corso attivabile su richiesta

Segnalaci il tuo interesse: verifichiamo disponibilità del docente, formula e prima soluzione utile, senza alcun impegno.

Richiedi l’attivazione
DP 750 Microsoft Certified Azure Databricks Data Engineer Associate
Riferimento certificativo

Esame e certificazione di riferimento: DP-750 · Azure Databricks Data Engineer Associate

Voce verificata il 21/08/2026 contro fonti ufficiali Microsoft Learn / Microsoft Credentials.

DP-750Esame ufficiale Azure Databricks Data Engineer Associate

La certificazione Azure Databricks Data Engineer Associate è il riferimento governato del corso. Il riferimento non implica preparazione completa, esame incluso o conseguimento automatico della credenziale.

Risultati di apprendimento

Competenze operative sviluppate durante il corso

Ogni macroarea viene tradotta in competenze concrete, con l’obiettivo di costruire un metodo applicabile in contesti reali.

01

Configurare un ambiente Azure Databricks scegliendo compute, runtime e integrazioni coerenti con il workload.

02

Creare e organizzare cataloghi, schemi, tabelle, viste e volumi tramite Unity Catalog.

03

Proteggere gli oggetti dati con privilegi, identità, row filtering, column masking e secret management.

04

Applicare governance, tagging, lineage, auditing, retention e condivisione controllata dei dati.

05

Progettare modelli dati e pipeline di ingestione batch, streaming e change data capture.

06

Pulire, trasformare e caricare dati con SQL, Python e funzionalità native di Azure Databricks.

07

Implementare regole di qualità, aspettative, vincoli e gestione controllata dello schema drift.

08

Distribuire, orchestrare, monitorare e risolvere problemi di job e pipeline di data engineering.

È il corso giusto per te se

Il percorso DP-750 è adatto a chi vuole sviluppare competenze Microsoft applicabili nel lavoro

  • vuoi approfondire Implement data engineering solutions using Azure Databricks;
  • lavori o vuoi crescere nell'area Data / AI / Analytics / Database;
  • cerchi un corso live con docente per collegare contenuti Microsoft e scenari professionali;
  • vuoi orientare le competenze verso Microsoft Certified: Azure Databricks Data Engineer Associate.
  • vuoi consolidare i contenuti attraverso esercitazioni guidate e scenari pratici.
Requisiti consigliati

Prerequisiti e livello di ingresso

Microsoft indica conoscenze fondamentali di data analytics, cloud storage e organizzazione dei dati, dimestichezza con SQL e Python, familiarità con notebook, Azure Databricks e Unity Catalog, nozioni di sicurezza Azure e Microsoft Entra ID e fondamenti di Git.

Si consiglia la frequenza del seguente corso come prerequisito:

Verifica l’idoneità con il nostro team
Formazione Microsoft realmente live

Docente, classe e confronto in tempo reale

Il corso viene erogato live con docente e calendario. Concetti, servizi e scenari Microsoft vengono spiegati e contestualizzati durante la lezione, con spazio per domande, confronto e verifica della comprensione.

Materiali e risorse Microsoft supportano il percorso ma non sostituiscono l’esperienza live con il docente.

Docente in diretta

Spiegazione, dimostrazioni, domande e chiarimenti durante il corso.

Classe reale

Ritmo comune, calendario e confronto con altri partecipanti.

Riferimenti Microsoft

Contenuti tecnici e didattici allineati ai riferimenti ufficiali Microsoft previsti per il corso.

Contesto professionale

Le competenze vengono collegate a ruoli, processi e scenari di utilizzo reali.
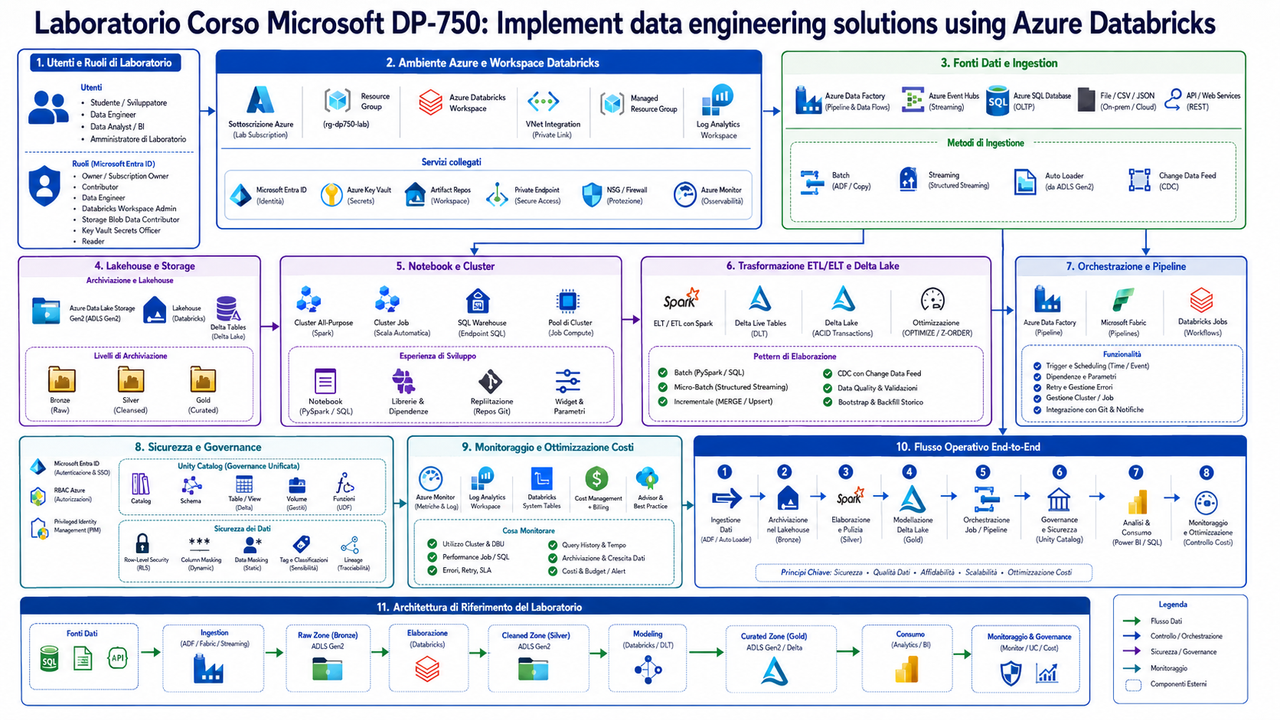
Laboratorio Corso Microsoft DP 750 Implement data engineering solutions using Azure Databricks

Dalla configurazione del workspace al deployment e troubleshooting dei workload.

Laboratorio Azure Databricks

Costruisci una pipeline dati governata con Azure Databricks

Il laboratorio segue un flusso end-to-end: workspace e compute, Unity Catalog, sicurezza, ingestione, trasformazioni, data quality, orchestrazione, monitoraggio e troubleshooting.

Workspace & computeConfiguri risorse Databricks adatte al workload e ne verifichi runtime, accessi e dipendenze.
Unity CatalogCrei oggetti governati, assegni privilegi e proteggi dati sensibili con controlli granulari.
Data pipelineIngerisci e trasformi dati batch o incrementali con controlli di qualità espliciti.
OperationsOrchestri job, analizzi run e log e risolvi un failure documentando il processo.

Le attività pratiche Vega Training seguono le aree e gli esercizi pubblicati nel percorso Microsoft DP-750 e vengono adattate all'ambiente disponibile per l'edizione.

Formula intensiva

Un percorso concentrato e intensivo

Contenuti, attività laboratoriali e qualità didattica restano centrali. Cambiano soltanto distribuzione delle ore e ritmo di consolidamento.

Formula intensiva4 giorni

Percorso live concentrato in giornate consecutive, con docente e ritmo coerente con il programma Microsoft del corso.

  • lezioni live con docente
  • programma concentrato
  • spazio per domande e confronto
  • attività pratiche guidate
Cosa include il percorso

Tutto ciò che serve per frequentare con sicurezza

Non soltanto lezioni: il percorso integra didattica live, pratica guidata e assistenza continua. Qui trovi ciò che Vega Training mette concretamente a disposizione per accompagnarti durante la formazione.

Lezioni live e interattive

Docente e partecipanti collegati in tempo reale, con la possibilità di intervenire e chiedere chiarimenti.

Docenti qualificati

Professionisti selezionati per competenza tecnica e capacità didattica, con le abilitazioni richieste dai vendor.

Laboratori pratici

Ambienti didattici sicuri e collaudati per applicare concretamente quanto affrontato durante le lezioni.

Supporto tecnico

Assistenza sulla piattaforma e sugli ambienti pratici, per lasciare il docente concentrato sulla formazione.

Materiali didattici

Documentazione, esercitazioni e risorse previste dallo specifico percorso.

Calendario tutelato

Le eventuali lezioni annullate da Vega Training vengono recuperate senza ridurre il monte ore del corso.

Attestato finale

Al termine del percorso viene rilasciato l’attestato di partecipazione Vega Training.

Formazione IT dal 2002 Formazione live online dal 2008 Sistema qualità certificato ISO 9001 EA37

FacultyMicrosoftVega Training

Competenza tecnica e capacità didattica

I docenti Vega Training uniscono esperienza tecnica e capacità didattica: durante il corso puoi fare domande, approfondire casi reali e confrontarti sui problemi che incontri nel lavoro.
Programma completo, organizzato per aree

Prima una visione d’insieme, poi tutto il dettaglio

Apri le singole aree per vedere argomenti, competenze e attività pratiche previste. Il programma ti permette di capire subito cosa affronterai e con quale progressione.

Esplorare Azure Databricks e i workload di data engineering
Comprendere l'architettura di Azure Databricks
Integrare Azure Databricks con i servizi Microsoft
Selezionare e configurare il compute
Creare e organizzare gli oggetti con Unity Catalog
Proteggere gli oggetti Unity Catalog
Governare gli oggetti Unity Catalog
Progettare il modello dati
Ingerire dati batch e streaming
Pulire, trasformare e caricare i dati
Implementare la qualità dei dati
Distribuire e mantenere pipeline e workload
Attività laboratoriali
Esplorare Azure Databricks e i workload di data engineering
  • Ruolo di Azure Databricks nell'architettura lakehouse e nei workload di data engineering
  • Workspace, notebook, SQL editor e strumenti disponibili al data engineer
  • Tipologie di workload supportate: elaborazione batch, streaming, analytics e machine learning
  • Relazione tra storage cloud, Delta Lake, compute e metastore
  • Organizzazione del lavoro collaborativo e separazione tra sviluppo, test e produzione
Comprendere l'architettura di Azure Databricks
  • Control plane e compute plane
  • Workspace, metastore e componenti di esecuzione
  • Accesso ai dati e separazione tra compute e storage
  • Architetture serverless e classic compute
  • Scelte architetturali per affidabilità, sicurezza e scalabilità
Integrare Azure Databricks con i servizi Microsoft
  • Integrazione con Azure Data Lake Storage e servizi dati Azure
  • Scenari di integrazione con Microsoft Fabric e Power BI
  • Sviluppo e gestione del codice con Visual Studio Code e Git
  • Integrazione con Microsoft Purview per catalogazione e governance
  • Scenari di interoperabilità con servizi AI e strumenti Microsoft collegati al dato
Selezionare e configurare il compute
  • Compute all-purpose, job compute e SQL warehouse
  • Serverless compute e classic compute
  • Autoscaling e dimensionamento delle risorse
  • Databricks Runtime e compatibilità dei workload
  • Photon e considerazioni prestazionali
  • Gestione di librerie, dipendenze e configurazioni del cluster
  • Controllo degli accessi alle risorse di compute
Creare e organizzare gli oggetti con Unity Catalog
  • Metastore, cataloghi e schemi
  • Managed table ed external table
  • Viste e materializzazione della logica di accesso ai dati
  • Volumi per file e dati non tabellari
  • External location e credenziali di storage
  • Foreign catalog e accesso governato a origini esterne
  • Creazione e gestione degli oggetti tramite SQL e interfaccia Databricks
Proteggere gli oggetti Unity Catalog
  • Principals, gruppi, service principal e identità gestite
  • GRANT, REVOKE e modello dei privilegi sugli oggetti Unity Catalog
  • Principio del minimo privilegio e separazione delle responsabilità
  • Row filtering e column masking per proteggere dati sensibili
  • Secret management e integrazione con Azure Key Vault
  • Accesso applicativo tramite service principal e managed identity
Governare gli oggetti Unity Catalog
  • Descrizioni di tabelle e colonne per rendere il dato comprensibile
  • Tag e Attribute-Based Access Control per policy governate
  • Lineage per ricostruire origine, trasformazioni e dipendenze del dato
  • Audit delle operazioni e tracciamento degli accessi
  • Retention e gestione del ciclo di vita degli oggetti
  • Delta Sharing per condividere dati in modo controllato
Progettare il modello dati
  • Scelta della granularità e struttura delle tabelle
  • Delta Lake e formati tabellari utilizzati nel lakehouse
  • Partizionamento, clustering e organizzazione fisica dei dati
  • Modellazione di dati incrementali e Slowly Changing Dimensions
  • Bilanciamento tra semplicità, performance e manutenibilità
Ingerire dati batch e streaming
  • Lakeflow Connect per integrazioni gestite
  • Ingestione tramite notebook e codice personalizzato
  • Caricamenti SQL e operazioni batch
  • Change Data Capture e gestione dei dati incrementali
  • Structured Streaming per flussi in tempo reale
  • Auto Loader per individuazione e ingestione incrementale dei file
  • Lakeflow Spark Declarative Pipelines per pipeline dichiarative
Pulire, trasformare e caricare i dati
  • Profilazione dei dati e individuazione delle anomalie
  • Conversione e normalizzazione dei tipi di dato
  • Gestione di duplicati e valori null
  • Filtri, aggregazioni e trasformazioni derivate
  • Join e set operation tra dataset
  • Pivot, unpivot e denormalizzazione quando necessaria
  • Append, overwrite e MERGE per caricare i risultati nelle tabelle target
Implementare la qualità dei dati
  • Schema enforcement e validazione strutturale
  • Gestione controllata dello schema evolution e dello schema drift
  • Constraint e regole di integrità applicabili al dato
  • Expectations per definire controlli di qualità nelle pipeline
  • Gestione delle righe non conformi e strategie di quarantena
  • Metriche di qualità e criteri per il rilascio dei dataset
Distribuire e mantenere pipeline e workload
  • Lakeflow Jobs per orchestrare task e dipendenze
  • Parametri, retry, timeout e gestione degli errori nei job
  • Schedulazione ed esecuzione event-driven dei workload
  • Gestione del codice con repository Git e workflow di sviluppo collaborativo
  • Principi CI/CD per notebook, job e pipeline Databricks
  • Separazione delle configurazioni tra ambienti di sviluppo, test e produzione
  • Monitoraggio delle esecuzioni e analisi dei failure
  • Ottimizzazione e manutenzione continuativa dei workload di data engineering
Attività laboratoriali
  • Esplorare un workspace Azure Databricks e ricostruirne componenti, storage e flusso di esecuzione
  • Creare e configurare un compute adatto a un workload di data engineering, verificando runtime e librerie
  • Creare un catalogo Unity Catalog con schema, tabelle, viste e volume e verificarne la gerarchia
  • Applicare privilegi a utenti e service principal e testare row filtering e column masking su dati sensibili
  • Collegare un secret a un workload usando un meccanismo di secret management coerente con Azure Key Vault
  • Ingerire un dataset incrementale con Auto Loader o pipeline Lakeflow e controllare nuovi arrivi e schema drift
  • Pulire e trasformare dati con SQL o Python applicando deduplica, gestione dei null, join, aggregazioni e MERGE
  • Definire expectations o regole di qualità e verificare il comportamento su record non conformi
  • Creare un job multi-step con dipendenze, parametri e retry, quindi analizzarne run history e log
  • Simulare un errore di pipeline, individuarne la causa e documentare la correzione e il controllo post-fix
Per aziende, enti e team

DP-750 per professionisti e team aziendali

Vega Training può erogare Implement data engineering solutions using Azure Databricks in open class o come classe dedicata per team che lavorano su Data / AI / Analytics / Database, concordando calendario e organizzazione con l'azienda.

1 partecipanteOpen class

Inserimento in una data pubblica, con fattura e referente aziendale.

2–8 partecipantiPiano team

Calendario, coordinamento e condizioni dedicate in base alle esigenze del gruppo.

Classe riservataEdizione dedicata

Modalità organizzative e calendario concordabili, mantenendo programma, obiettivi e qualità didattica del percorsoMicrosoft.

Domande frequenti

Le informazioni utili prima di richiedere il corso

A chi è rivolto il corso DP-750?

Data engineer con conoscenze fondamentali di analytics, cloud storage e organizzazione dei dati, abituati a lavorare con SQL e Python e con familiarità con notebook, Azure Databricks, Unity Catalog e principi di data engineering.

Quali prerequisiti sono consigliati?

Microsoft indica conoscenze fondamentali di data analytics, cloud storage e organizzazione dei dati, dimestichezza con SQL e Python, familiarità con notebook, Azure Databricks e Unity Catalog, nozioni di sicurezza Azure e Microsoft Entra ID e fondamenti di Git.

Cosa saprò fare al termine del corso?

Configurare un ambiente Azure Databricks scegliendo compute, runtime e integrazioni coerenti con il workload. Creare e organizzare cataloghi, schemi, tabelle, viste e volumi tramite Unity Catalog.

DP-750 copre anche Unity Catalog e data governance?

Sì. Include cataloghi, schemi, tabelle, volumi, privilegi, row filtering, column masking, lineage, auditing, retention e Delta Sharing.

Sono previste attività pratiche e laboratoriali?

Sì. Il laboratorio segue un flusso end-to-end: workspace e compute, Unity Catalog, sicurezza, ingestione, trasformazioni, data quality, orchestrazione, monitoraggio e troubleshooting.

Come si collega il corso al percorso di certificazione?

Le competenze del corso sono collegate all'esame DP-750, riferimento della certificazione Microsoft Certified: Azure Databricks Data Engineer Associate.

Qual è la durata ufficiale del corso?

La durata indicata da Microsoft è di 4 giorni. Le formule disponibili e le prossime date sono riportate nella scheda del corso.

Quali linguaggi e strumenti è utile conoscere prima di DP-750?

Microsoft indica dimestichezza con SQL e Python, notebook, Databricks, Unity Catalog, cloud storage, Git e concetti di sicurezza Azure.

Parliamo del tuo obiettivo

Richiedi informazioni suDP-750 · Implement data engineering solutions using Azure Databricks

Scegli il percorso privato oppure aziendale. Il modulo mostra soltanto i campi utili e conserva corso, pagina e contesto della richiesta.

Sei un privato o ci contatti da un’azienda?

Scegli il percorso più adatto: il modulo mostra soltanto i campi utili alla tua richiesta.

Privato / professionista

Informazioni per te

Verifichiamo formula, calendario, investimento e idoneità senza obblighi.