Il rischio in un progetto di machine learning non è soltanto scegliere un algoritmo sbagliato. Dati incompleti, leakage, metriche incoerenti e cambiamenti della distribuzione possono far apparire valido un modello che in esercizio non funziona. DataAI mette insieme matematica, trattamento dei dati e disciplina operativa del ciclo di vita.
In breve: destinatari, livello e obiettivo
- Corso di riferimento: CompTIA DataAI.
- A chi serve: Per data analyst esperti, specialisti dati e figure IT che vogliono operare su progetti AI. Sono utili basi di statistica, programmazione e trattamento dei dati.
- Programma: competenze, scenari e argomenti pubblicati del corso, senza presupporre esame o voucher compresi.
- Calendario e modalità: la fonte aggiornata è la scheda completa del corso CompTIA DataAI; una data proposta non equivale a una partenza confermata.
Perché queste competenze sono importanti nel lavoro
Un classificatore addestrato su dati storici migliora i KPI nei test ma produce risultati peggiori dopo il rilascio. È necessario confrontare campioni di training e produzione, verificare leakage e drift, analizzare errori per classe e decidere se riaddestrare, correggere i dati o tornare alla versione precedente.
Le competenze chiave da padroneggiare
- Preparazione dei dati, qualità, trasformazioni e feature engineering.
- Machine learning supervisionato e non supervisionato.
- Valutazione dei modelli, metriche e prevenzione di overfitting.
- Natural Language Processing e concetti di generative AI.
- MLOps: versionamento, deploy, monitoraggio e aggiornamenti.
- Sicurezza, governance, etica e affidabilità delle soluzioni AI.
Programma tecnico: gli argomenti spiegati per area
Le aree seguenti derivano dal programma corrente pubblicato per il corso: aiutano a leggere le competenze nel loro contesto, prima di scegliere una specifica edizione.
Matematica e statistica per data science
- Probability e distributions
- Descriptive e inferential statistics
- Correlation e hypothesis concepts
- Linear algebra e calculus concepts per ML
Data acquisition, preparation e feature engineering
- Data source e ingestion
- Cleaning e transformation
- Feature selection e engineering
- Train, validation e test split
Exploratory analysis e model framing
- EDA e visualization
- Problem definition
- Baseline e target metric
- Leakage e bias awareness
Supervised machine learning
- Regression
- Classification
- Tree-based model
- Performance metric e validation
Unsupervised learning
- Clustering
- Dimensionality reduction
- Anomaly detection
- Pattern discovery e evaluation
Model evaluation e optimization
- Cross-validation
- Hyperparameter tuning
- Bias-variance trade-off
- Explainability e error analysis
Machine learning lifecycle e MLOps
- Experiment tracking
- Versioning di dati e modelli
- CI/CD per ML
- Deployment e rollback
Monitoring, drift e model governance
- Data drift e concept drift
- Performance monitoring
- Model inventory e lineage
- Risk, approval e responsible AI
Natural language processing e generative AI
- Text preprocessing
- Embeddings e vector search
- LLM e generative AI concepts
- RAG e evaluation
Computer vision e specialized applications
- Image classification concepts
- Object detection concepts
- Recommendation systems
- Time series e forecasting
Data science production e communication
- API e serving
- Batch e real-time inference
- Cost e scalability
- Communication di risultati e limiti
Uno scenario applicativo, dal problema alla verifica
Un modello di classificazione dà buoni risultati in test ma peggiora in esercizio: vanno distinti data drift, errori di pipeline, misure di qualità e problemi di generalizzazione.
Un esercizio non è completo quando la modifica viene semplicemente applicata. È necessario definire il risultato atteso, misurare lo stato iniziale, verificare ciò che cambia e conservare le evidenze utili per spiegare l'esito o ripristinare la situazione precedente.
Laboratori e attività pratiche previste dal programma
- Preparare dataset e feature
- Allenare e valutare modelli
- Confrontare metriche e tuning
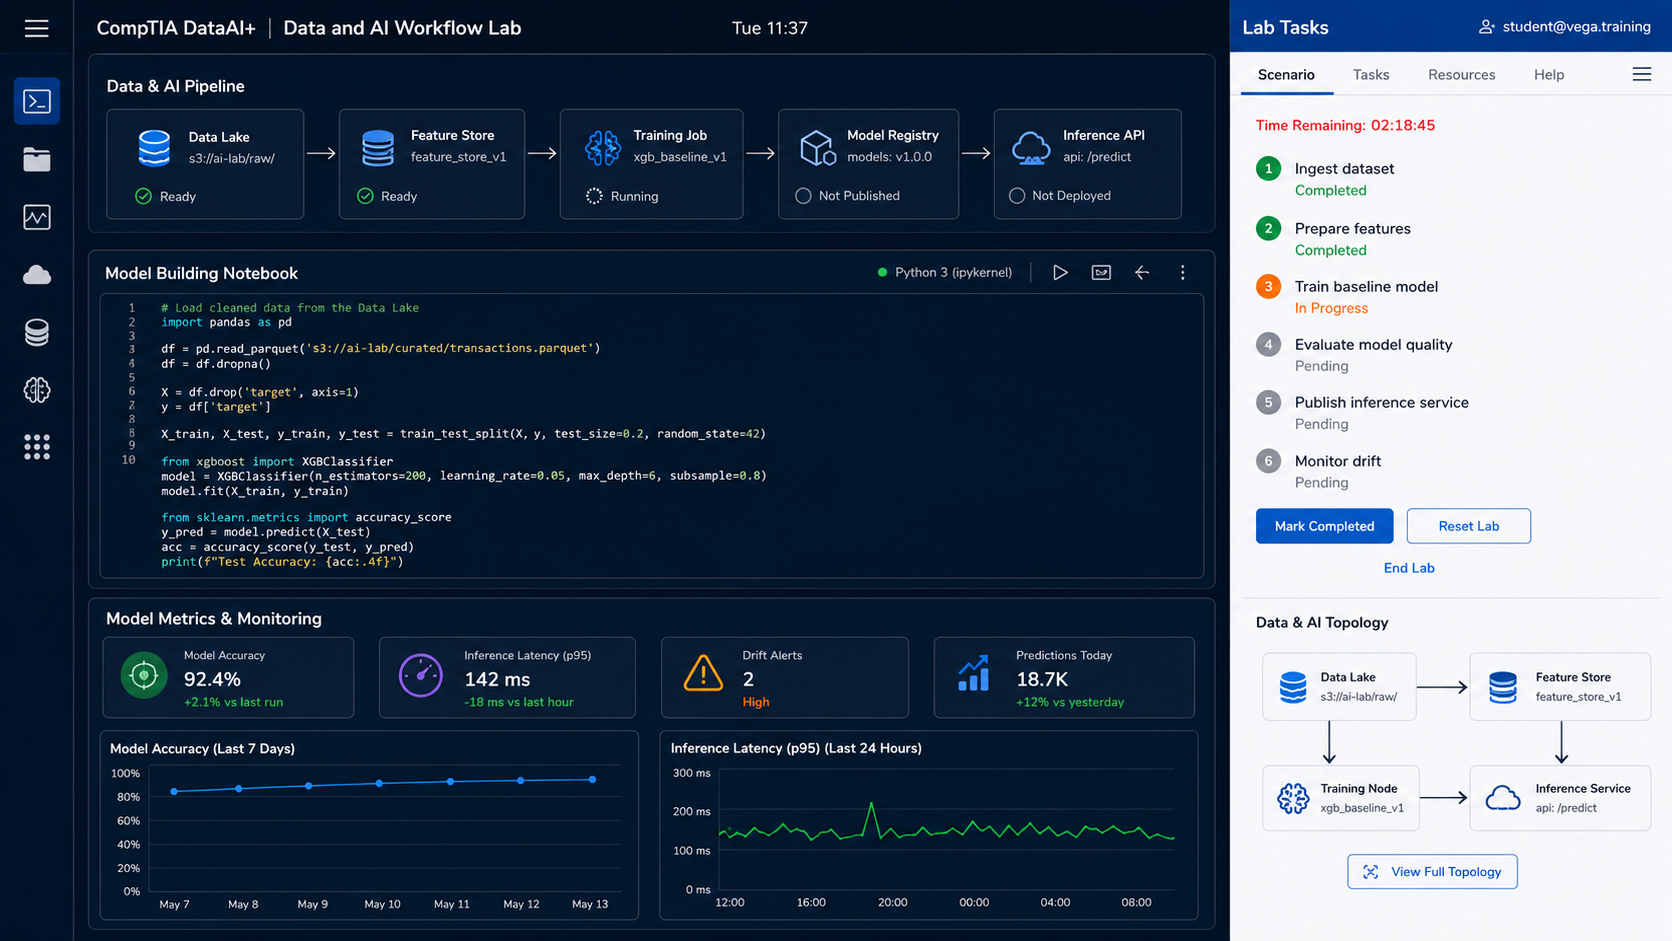
- Costruire un workflow MLOps
- Monitorare drift e documentare un modello
Le attività provengono dal programma pubblicato. Ambienti, durata delle esercitazioni, materiali e accessi sono regolati dalla specifica edizione: non devono essere dedotti dalla sola descrizione della guida.
Errori frequenti e scelte da evitare
- Utilizzare informazioni future durante il training causando data leakage.
- Valutare un classificatore usando soltanto accuracy su classi sbilanciate.
- Non mantenere versioni di dati, feature e modelli.
- Distribuire un modello senza metriche di drift e qualità.
- Confondere un esperimento di notebook con una pipeline MLOps pronta.
Verifica i prerequisiti prima dell'iscrizione
- Avere basi di statistica e probabilità.
- Conoscere dataset, pulizia e trasformazioni.
- Saper leggere codice o notebook di analisi.
- Comprendere criteri di valutazione di un modello.
Se il corso interessa un team aziendale
L'organizzazione ha bisogno di criteri condivisi per il passaggio dalla sperimentazione alla produzione. Il corso dà linguaggio e strumenti per documentare dati, ipotesi, metriche e responsabilità.
Edizioni, modalità di frequenza e certificazione
Consulta la scheda completa del corso CompTIA DataAI per formule, durata, prezzi, iscrizione e calendario aggiornato. Le edizioni possono essere pianificate, proposte o attivabili su richiesta, con stati distinti.
Verifica contenuti aggiornati, esami e requisiti nella documentazione ufficiale del vendor. La frequenza del corso non conferisce automaticamente un titolo e non implica voucher incluso.
Domande frequenti
Domande frequenti
È un corso per chi non ha mai studiato dati?
È utile partire da basi di analisi e programmazione.
È focalizzato soltanto sui chatbot?
No, tratta data science, ML e lifecycle delle soluzioni.
Che cosa significa MLOps?
Le pratiche operative per versionare, rilasciare e monitorare modelli.
La certificazione è inclusa?
La formazione non attribuisce automaticamente la credenziale CompTIA.
Perché non basta una metrica unica per valutare un modello?
I costi degli errori e lo sbilanciamento delle classi cambiano l'utilità di accuracy, precision, recall e altre misure.
Data drift e concept drift sono uguali?
No. Il primo riguarda la distribuzione dei dati, il secondo la relazione fra input e risultato.
<small>Approfondimento editoriale Vega Training basato sul programma del corso e sulle fonti indicate. Gli argomenti e gli esami possono variare nel tempo.</small>