Google Cloud Training Partner
Formazione Google Cloud nel perimetro del programma Training Partner, con corsi instructor-led e contenuti allineati ai riferimenti ufficiali Google Cloud.
Scopri Google Cloud Training Partner
T-DICDF-I · formazione Google Cloud instructor-led · 2 giorni
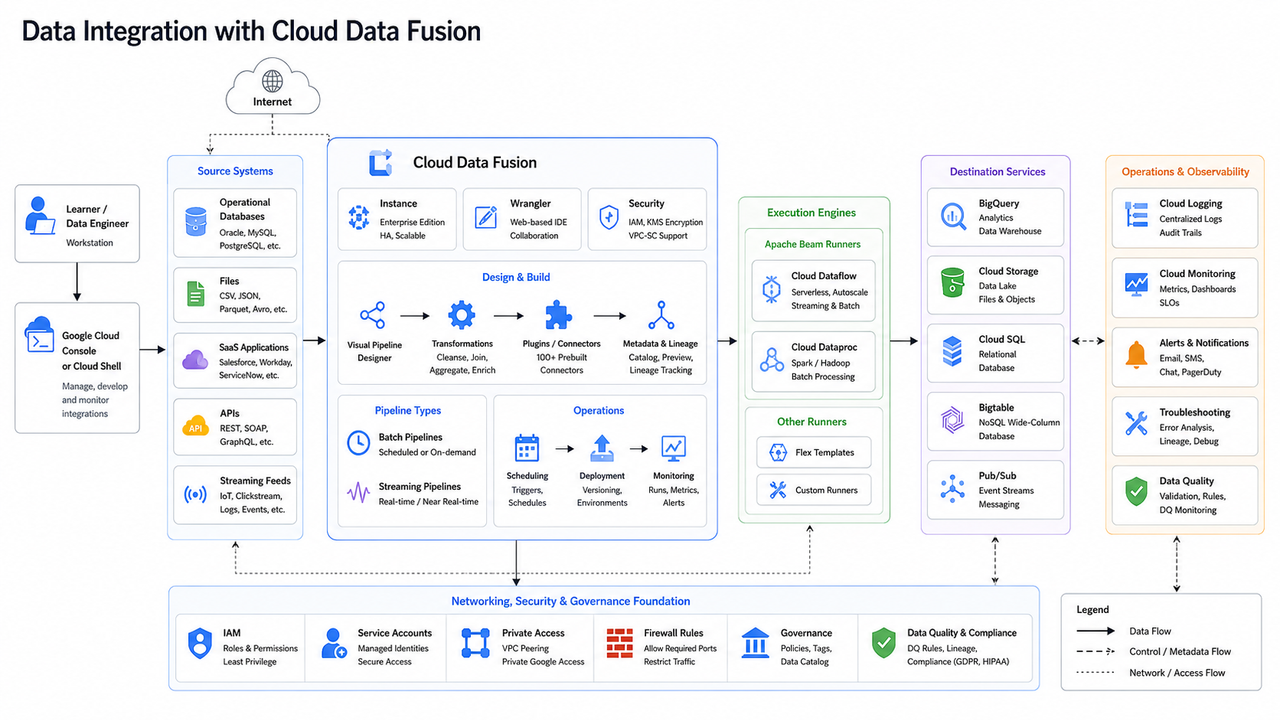
Corso instructor-led di due giornate dedicato all'integrazione dati con Cloud Data Fusion. Il percorso affronta architettura e componenti della piattaforma, connessioni e plugin, Wrangler, pipeline visuali batch e streaming, metadata e lineage, deployment su diversi execution engine, scheduling, monitoring e troubleshooting operativo.
È consigliata esperienza di base con data integration, ETL/ELT, database e formati dati, oltre a familiarità con i concetti fondamentali di Google Cloud. La conoscenza di pipeline batch, streaming e dei principali servizi dati Google Cloud permette di sfruttare meglio le esercitazioni.
Formazione Google Cloud nel perimetro del programma Training Partner, con corsi instructor-led e contenuti allineati ai riferimenti ufficiali Google Cloud.
Scopri Google Cloud Training Partner
Il corso contribuisce a una parte del percorso certificativo ufficiale: non viene presentato come preparazione completa all'esame.
Consulta la certificazione Google CloudIl corso può essere attivato per privati, professionisti, aziende ed enti, senza attendere la pubblicazione di una data a calendario.
Segnalaci il tuo interesse: verifichiamo disponibilità del docente, formula e prima soluzione utile, senza alcun impegno.
Richiedi l’attivazione
Certificazione Google Cloud attiva verificata sulla directory ufficiale e sulla pagina della singola credenziale il 28/08/2026.
Il superamento dell’esame consente di ottenere la certificazione Professional Data Engineer, nel rispetto dei requisiti previsti dal vendor.
L’esame non è incluso nella quota. Il voucher può essere acquistato separatamente quando decidi di sostenere la prova.
Ogni macroarea viene tradotta in competenze concrete, con l’obiettivo di costruire un metodo applicabile in contesti reali.
Descrivere l'architettura Cloud Data Fusion e il ruolo dei suoi componenti principali.
Configurare connessioni, source, sink e plugin per integrare sorgenti eterogenee.
Usare Wrangler e pipeline visuali per trasformare dati batch e streaming.
Applicare metadata e data lineage per comprendere dipendenze e trasformazioni.
Distribuire e schedulare pipeline scegliendo l'execution engine appropriato.
Monitorare esecuzioni, log ed errori e applicare un processo strutturato di troubleshooting.
È consigliata esperienza di base con data integration, ETL/ELT, database e formati dati, oltre a familiarità con i concetti fondamentali di Google Cloud. La conoscenza di pipeline batch, streaming e dei principali servizi dati Google Cloud permette di sfruttare meglio le esercitazioni.
Si consiglia la frequenza del seguente corso come prerequisito:
Durante le lezioni live, concetti, architetture, comandi, console e attività laboratoriali vengono affrontati con il docente nel perimetro del singolo corso.
Se il corso contribuisce a una certificazione Google Cloud, il collegamento viene indicato con chiarezza; l'eventuale voucher d'esame è incluso solo quando espressamente indicato.
Lezione live con docente, spazio per domande e verifica dei passaggi tecnici.
Programma, destinatari, prerequisiti e durata sono presentati in modo chiaro prima dell’iscrizione.
Le attività laboratoriali sono integrate nel programma e sviluppate sui contenuti del singolo percorso.
Il collegamento alle certificazioni viene presentato per il contributo effettivo del corso, senza sovrastimare la copertura.
Attività pratica integrata nel percorso Google Cloud.
Le attività laboratoriali sono integrate nel programma del corso e vengono svolte sui servizi, sugli strumenti e sugli scenari trattati nel percorso.
Le esercitazioni fanno parte del percorso didattico e vengono contestualizzate dal docente durante la formazione live.
Contenuti, attività laboratoriali e qualità didattica restano centrali. Cambiano soltanto distribuzione delle ore e ritmo di consolidamento.
Non soltanto lezioni: il percorso integra didattica live, pratica guidata e assistenza continua. Qui trovi ciò che Vega Training mette concretamente a disposizione per accompagnarti durante la formazione.
Docente e partecipanti collegati in tempo reale, con la possibilità di intervenire e chiedere chiarimenti.
Professionisti selezionati per competenza tecnica e capacità didattica, con le abilitazioni richieste dai vendor.
Ambienti didattici sicuri e collaudati per applicare concretamente quanto affrontato durante le lezioni.
Assistenza sulla piattaforma e sugli ambienti pratici, per lasciare il docente concentrato sulla formazione.
Documentazione, esercitazioni e risorse previste dallo specifico percorso.
Le eventuali lezioni annullate da Vega Training vengono recuperate senza ridurre il monte ore del corso.
Quando prevista, la formazione comprende indicazioni sul relativo esame e sulla preparazione necessaria.
Al termine del percorso viene rilasciato l’attestato di partecipazione Vega Training.
Formazione IT dal 2002 Formazione live online dal 2008 Sistema qualità certificato ISO 9001 EA37
I docenti Vega Training uniscono esperienza tecnica e capacità didattica: durante il corso puoi fare domande, approfondire casi reali e confrontarti sui problemi che incontri nel lavoro.
Apri le singole aree per vedere argomenti, competenze e attività pratiche previste. Il programma ti permette di capire subito cosa affronterai e con quale progressione.
Il corso può essere organizzato per team aziendali mantenendo prerequisiti, programma tecnico e attività laboratoriali coerenti con il percorso formativo.
Inserimento in una data pubblica, con fattura e referente aziendale.
Calendario, coordinamento e condizioni dedicate in base alle esigenze del gruppo.
Modalità organizzative e calendario concordabili, mantenendo programma, obiettivi e qualità didattica del percorsoGoogle Cloud.
Cloud Data Fusion viene usato come piattaforma gestita di data integration per costruire pipeline visuali, collegare sorgenti e destinazioni tramite plugin e gestire trasformazioni e workflow ETL/ELT.
Sì. Il programma include data wrangling e trasformazioni visuali per preparare i dati prima dell'esecuzione delle pipeline, mantenendo chiaro il passaggio dalla progettazione al run operativo.
Sì. Metadata e lineage sono collegati a esecuzione, scheduling, logging e troubleshooting per fornire visibilità sul flusso dei dati e sulle dipendenze operative della pipeline.
Sì. Il corso include attività laboratoriali integrate nel programma, tra cui Pipeline visuale ETL, Wrangler e data preparation. Le esercitazioni sono contestualizzate dal docente e coerenti con contenuti e obiettivi del percorso.
No. Il corso è centrato sull'approccio visuale e sui plugin di Cloud Data Fusion, pur richiedendo di comprendere sorgenti, trasformazioni, parametri, deployment e comportamento operativo del flusso dati.
Scegli il percorso privato oppure aziendale. Il modulo mostra soltanto i campi utili e conserva corso, pagina e contesto della richiesta.
Scegli il percorso più adatto: il modulo mostra soltanto i campi utili alla tua richiesta.
Verifichiamo formula, calendario, investimento e idoneità senza obblighi.
Indicaci il contesto essenziale: open class, piano team o classe dedicata.
Passa dal singolo corso al catalogo, alle certificazioni, alla pagina Training Partner e al Google Cloud Partner Network.
Privacy e cookie
Usiamo cookie necessari. Al primo accesso Analytics e Google Ads sono attivi; puoi rifiutarli o scegliere le categorie.